


Эмбеддинг
Эмбеддинг (Embedding) — это числовое векторное представление объекта, которое позволяет модели учитывать его свойства и смысловые связи с другими объектами.
Простыми словами, эмбеддинг переводит слова, предложения, документы, изображения или другие данные в набор чисел, с которым может работать нейронная сеть.
Что такое эмбеддинг
Эмбеддинг используется в искусственном интеллекте и машинном обучении для преобразования данных в числовую форму. Каждый объект получает собственный вектор — набор чисел фиксированной размерности. Эти векторы располагаются в многомерном пространстве так, что похожие по смыслу объекты оказываются ближе друг к другу.
Например, векторы слов «автомобиль» и «машина» будут расположены ближе друг к другу, чем вектор слова «ромашка».
Условно это можно представить так:
| Объект | Пример вектора | Смысловая близость |
|---|---|---|
| Автомобиль | [0,82; 0,74; 0,15] | — |
| Машина | [0,79; 0,71; 0,18] | близка к «автомобилю» |
| Ромашка | [0,12; 0,20; 0,91] | далека от «автомобиля» |
В реальных моделях векторы содержат значительно больше значений, а их конкретные координаты определяются моделью.
Как работают эмбеддинги
Модель эмбеддингов преобразует исходный объект в числовой вектор. Для текста таким объектом может быть слово, токен, предложение или документ. В нейронных сетях токены преобразуются в эмбеддинги перед дальнейшей обработкой моделью.
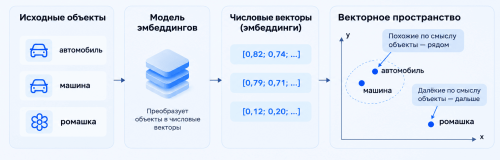
Сходство между векторами оценивают с помощью специальных метрик. Один из распространенных способов — косинусное сходство: чем оно выше, тем ближе векторы и тем больше семантическая близость объектов.
Вектор эмбеддинга — это набор числовых значений, в котором закодированы характеристики исходного объекта. Такое представление позволяет модели сравнивать объекты и определять их смысловую близость.
Какие бывают эмбеддинги
Основные виды эмбеддингов:
Word Embeddings — векторные представления отдельных слов;
Sentence и Document Embeddings — предложений и документов;
Image Embeddings — изображений;
Graph Embeddings — узлов и связей графа.
Текстовые эмбеддинги также могут быть статическими и контекстуальными. В статических моделях одно слово обычно имеет один вектор, а в контекстуальных его представление зависит от окружения. К известным моделям и методам создания текстовых эмбеддингов относятся Word2Vec и BERT.
Где применяются эмбеддинги
Эмбеддинги используют в семантическом поиске, рекомендательных системах, классификации и кластеризации данных, а также для поиска похожих документов и изображений. Они позволяют находить близкие по смыслу объекты, даже если в них нет одинаковых слов.
Эмбеддинги в нейросетях, LLM и RAG
В нейросетях эмбеддинги служат числовым представлением входных данных. В LLM токены преобразуются в векторы, которые затем обрабатывает модель.
В RAG-системах эмбеддинги используют для представления запросов и документов. Система сравнивает их векторы, находит семантически близкие фрагменты и передает найденную информацию языковой модели. Большие наборы таких векторов могут храниться в векторных базах данных, предназначенных для поиска по сходству.
 Предыдущая статья