

Токены дешевеют быстрее, чем почти любой другой ИТ-ресурс. По данным Epoch AI (сентябрь 2026 года), с 2023 по 2026 год стоимость ответа модели заданного уровня качества снижалась примерно на 47% в квартал. За год это падение в 13 раз.
Бюджеты на ИИ при этом растут. Gartner прогнозирует, что к 2028 году минимум половина проектов генеративного ИИ выйдет за рамки запланированного бюджета. Основная статья расходов в таких проектах — инференс, то есть работа уже обученной модели. По оценке аналитиков, на него придётся 70% затрат за весь жизненный цикл модели.
Причина роста расходов в объемах. Пилотный проект обрабатывает сотни запросов. Продакшен обрабатывает миллионы. ИИ-агент тратит несколько вызовов модели на одну задачу.
Снижать расходы можно на четырех уровнях:
Ниже разберем, что делать на каждом уровне и где экономия начинает сказываться на качестве.
Из чего складывается стоимость
Совокупную стоимость владения ИИ можно разделить на шесть типов затрат:
Большинство компаний не обучают модели с нуля. Для них обучение сводится к дообучению или выпадает совсем, и главными статьями становятся инференс и хостинг.
Отдельная скрытая статья расходов связана с простоем. Аренда GPU оплачивается за время, покупка оплачивается заранее. В обоих случаях расходы не зависят от того, работает оборудование на полную мощность или ждет запросов. В долгосрочной перспективе затраты на аренду могут сравняться со стоимостью покупки, поэтому загрузку оборудования стоит считать при любом формате.
Уровень 1. Где запускать модели и как за них платить
Выбор площадки определяет модель оплаты. Есть три основных варианта.
Модели по API через ИИ-шлюз. Компания платит за токены и не держит собственных GPU. Шлюз дает единую точку доступа к нескольким моделям, лимиты по проектам и учет расходов. Вариант подходит для старта, для переменной нагрузки и для задач, где нужны флагманские модели. Минус этого подхода в том, что затраты растут вместе с объемом обработанных токенов. При большом стабильном потоке запросов счета за услуги становятся заметной статьей бюджета.
GPU в облаке провайдера. Компания арендует серверы с GPU и запускает на них открытые модели. Оплата идет за время использования ресурсов, количество использованных токенов на затраты не влияет. Мощности предоставляются в публичном облаке, а также в частном, которое изолировано от других пользователей. Частное облако выбирают, когда компании требуется выделенный контур и повышенная изоляция данных. При работе с персональными данными граждан РФ также необходимо учитывать требования 152-ФЗ к их обработке и локализации.
Собственное оборудование. Компания получает полный контроль и берет на себя капитальные затраты. Вариант оправдан при высокой предсказуемой нагрузке и наличии собственной команды эксплуатации. Риски: сроки поставки, простой, устаревание оборудования и затраты на сервисную поддержку при параллельном импорте.
От чего зависит выбор
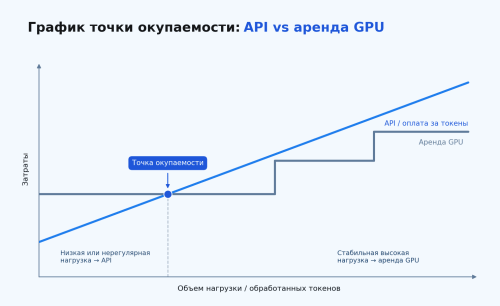
Главный показатель здесь — это стоимость одного запроса при реальной загрузке. Выделенное оборудование стоит одинаково при любом числе запросов. Если запросов в месяц становится в 10 раз меньше, каждый из них на том же оборудовании обходится примерно в 10 раз дороже.
Отсюда простое правило. Выделенный GPU выгоден, когда он загружен. Если нагрузка переменная или ее объем пока непонятен, дешевле платить за токены. Когда поток запросов стабилизировался, расчет стоит повторить. Пересматривать его полезно каждые несколько месяцев, потому что модели и цены меняются быстро. Многие компании в итоге комбинируют варианты: типовые запросы обрабатывает своя модель на GPU, редкие сложные задачи уходят во флагманские модели по API.
Какой GPU нужен под задачу
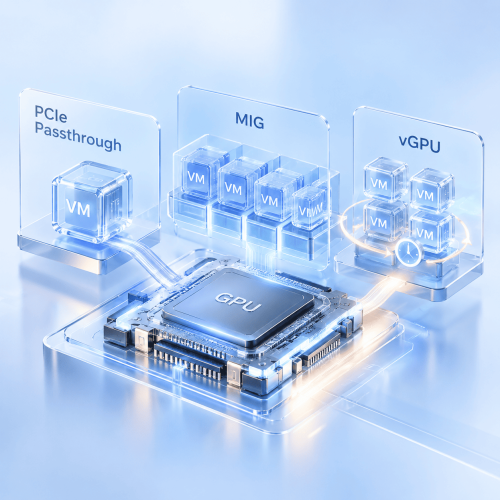
Переплата за железо часто возникает при закупке или аренде мощностей с запасом под будущие нагрузки. Для инференса один из главных параметров это объем видеопамяти. В нее должны поместиться веса модели и кэш контекста (KV-кэш), который растет с длиной диалога и числом одновременных пользователей.
Быстрая оценка: в 16-битном формате каждый миллиард параметров занимает около 2 ГБ. Модели на 70 млрд параметров нужно около 140 ГБ только под веса. После квантизации до 4 бит та же модель занимает примерно 35 ГБ. Обучение требует в несколько раз больше памяти, чем инференс той же модели, потому что GPU хранит еще градиенты и состояния оптимизатора.
| Задача | Что важно | Класс оборудования |
|---|---|---|
| Внутренние ассистенты, RAG, модели до 30–40 млрд параметров | Объём памяти, стоимость часа работы | GPU с 96 ГБ памяти, например NVIDIA RTX PRO 6000 Blackwell Server Edition |
| Крупные модели от 70 млрд параметров, много одновременных пользователей | Объем и пропускная способность памяти | NVIDIA A100/A800 (80 ГБ), NVIDIA H200 (141 ГБ) |
| Дообучение и обучение моделей | Связь между GPU, масштабирование на кластер | Кластеры NVIDIA HGX H200 и HGX B300 |
Уровень 2. Оптимизация самой модели
Этот уровень работает, когда модель запущена на собственных или арендованных GPU. По оценке McKinsey, квантизация и прунинг снижают стоимость токена на 85–95% и позволяют запускать нагруженные корпоративные сценарии без замены оборудования.
Модель по размеру задачи. Для классификации обращений, извлечения полей из документов или маршрутизации заявок модель на сотни миллиардов параметров избыточна. По данным Hugging Face, специализированная модель потребляет в 20–30 раз меньше энергии, чем универсальная.
Дистилляция. Маленькая модель учится воспроизводить ответы большой. По тем же данным, дистиллированные версии в 10–30 раз меньше исходных моделей.
Квантизация. Разрядность весов снижается с 16 бит до 8 или 4. Модель занимает меньше памяти, помещается на более доступный GPU и быстрее отвечает.
Прунинг. Из модели удаляются связи, которые слабо влияют на результат.
Батчинг. GPU обрабатывает несколько запросов одновременно, что позволяет эффективнее использовать вычислительные ресурсы и снижать стоимость обработки одного запроса.
Компиляция под оборудование. Инструменты вроде NVIDIA TensorRT перестраивают вычисления под конкретный GPU и ускоряют модель без изменения весов.
Спекулятивное декодирование. Небольшая черновая модель предлагает несколько токенов, большая проверяет их за один проход. Генерация ускоряется, а результат соответствует тому, что выдала бы большая модель.
Где экономия сказывается на качестве
Батчинг, компиляция и спекулятивное декодирование сохраняют качество ответов. У батчинга есть своя цена: чем больше пакет запросов, тем дольше ждет каждый пользователь ответа. Размер пакета подбирают под допустимую задержку.
Квантизация, прунинг, дистилляция и переход на модель меньшего размера меняют саму модель. Потери зависят от модели и задачи. Квантизация до 8 бит обычно почти незаметна. При 4 битах и агрессивном прунинге результат нужно проверять. Малые модели слабее справляются со сложными рассуждениями и длинными цепочками логики. После сжатия модель можно дообучить на своих данных, чтобы частично компенсировать снижение качества.
Правило одно: сравнивать исходную и оптимизированную модель на собственном наборе реальных запросов. Публичные бенчмарки для этого не годятся, они не отражают специфику конкретной компании.
Уровень 3. Оптимизация запросов
Этот уровень важен для тех, кто работает с моделями по API. Здесь платят за каждый токен, поэтому экономия начинается с того, сколько токенов отправляет приложение.
Маршрутизация. Простые запросы уходят на дешевую модель, сложные на мощную. Маршрутизация это первый способ снизить стоимость: компания перестает переплачивать за рутинные запросы, которым не нужна флагманская модель.
Кэширование промптов. Каждый запрос к модели содержит повторяющуюся часть: системные инструкции, описания инструментов, справочные данные. Провайдеры умеют сохранять эту часть в кэше. Повторное чтение из кэша стоит значительно дешевле обработки тех же токенов заново. Чтобы кэш срабатывал, неизменную часть промта ставят в начало, а данные конкретного запроса в конец.
Короткие инструкции. Каждое слово промта и каждое описание инструмента оплачиваются в каждом запросе. Инструкция начинается с задачи и обходится без повторов. Модель получает описания только тех инструментов, которые нужны в текущем сценарии. Меньше лишнего контекста означает меньше токенов и обычно более точные ответы: модели не приходится выбирать среди нерелевантных инструментов.
Лимиты для агентов. Каждый шаг агента означает отдельный вызов модели, иногда с полным контекстом. Ограничение числа шагов и токенов на одну задачу защищает от зацикливания и неожиданных счетов.
Уровень 4. Стоимость владения и FinOps
FinOps объединяет ИТ, финансы и бизнес вокруг общей задачи и помогает понимать, за что компания платит и что получает взамен. Для ИИ эта практика уже стала массовой. По данным FinOps Foundation, в 2026 году расходы на ИИ контролируют 98% опрошенных компаний. В 2025 году таких было 63%, в 2024 году 31%. Управление затратами на ИИ респонденты назвали главным навыком, который нужно развивать команде.
Что делать на практике:
Отдельный риск связан с переходом от пилотного проекта к продакшену. Готовая к продакшену система генеративного ИИ может стоить на порядки больше пилота. Закладывать это в бюджет нужно на этапе планирования.
AI-инфраструктура ITGLOBAL.COM
В инфраструктуре ITGLOBAL.COM доступны NVIDIA H200, RTX PRO 6000 Blackwell Server Edition и NVIDIA A100/A800, а также TPU-ускоритель SOPHGO SC7 HP75. Для обучения крупных моделей доступна аренда суперкомпьютера на базе NVIDIA SuperPOD. Компания может выбрать формат под свою нагрузку и требования к данным.
Такой набор позволяет начать с оплаты за токены через AIaaS и по мере роста нагрузки перейти на собственные модели на GPU, не меняя провайдера. Специалисты ITGLOBAL.COM помогут подобрать конфигурацию, при которой оборудование загружено, а расходы соответствуют реальной нагрузке.
Частые вопросы
 Предыдущая статья