Контекстные окна языковых моделей выросли до сотен тысяч токенов. Например, у Llama 3.1 это 128 тыс. токенов. Сейчас в один запрос помещаются договор целиком, кодовая база или многочасовая переписка с клиентом. Однако на практике длинному контексту не хватает видеопамяти. Модель загрузилась на GPU и отвечает на короткие вопросы, но на длинном документе сервер выдает ошибку нехватки памяти или начинает обслуживать меньше пользователей.
При длинном контексте значительную часть дополнительной памяти может занимать KV Cache (KV-кеш). Во время инференса он хранит ключи (K) и значения (V) attention для уже обработанных токенов, чтобы модель не пересчитывала их на каждом шаге генерации.
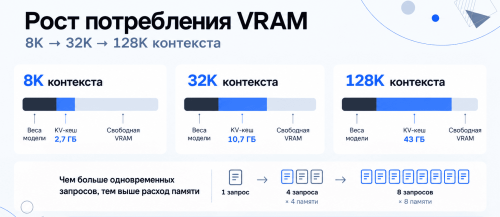
Веса модели занимают относительно фиксированный объем VRAM, а KV-кеш увеличивается вместе с длиной контекста и числом одновременных запросов. Поэтому при длинном контексте он может занять десятки гигабайт видеопамяти, и его объем нужно учитывать вместе с весами модели.
Как работает KV-кеш
Языковая модель генерирует ответ по одному токену. Чтобы сгенерировать следующий токен, механизм внимания (attention) сопоставляет запрос текущего токена с ключами предыдущих токенов контекста. Для этого на каждом слое модели для каждого токена вычисляются два вектора: ключ (key) и значение (value).
Без кеширования модель пересчитывала бы ключи и значения всего контекста на каждом шаге генерации. Для ответа из 500 токенов их пришлось бы заново вычислять для всей уже обработанной последовательности. KV-кеш сохраняет рассчитанные векторы в видеопамяти. На каждом шаге модель считает их только для нового токена и использует данные из кеша для предыдущих.
Поэтому работа модели делится на две фазы.
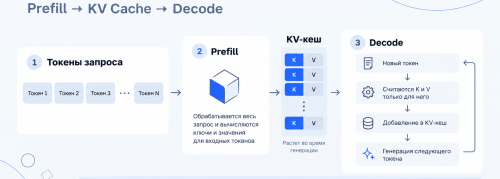
Предзаполнение (prefill) — модель обрабатывает весь входной контекст за один проход и заполняет KV-кеш. Эта фаза нагружает вычислительные блоки GPU и определяет время до первого токена.
Генерация (decode) — модель выдает ответ токен за токеном. На каждом шаге она читает из памяти веса и весь накопленный KV-кеш. Эта фаза ограничена пропускной способностью памяти.
Кеш снижает объем вычислений за счет памяти. Чем длиннее контекст, тем больше памяти он занимает.
Сколько памяти занимает KV-кеш
Объем кеша на один токен считается по формуле:
Множитель 2 — это два вектора, ключ и значение. Чтобы получить объем для запроса, результат умножают на длину контекста в токенах. Чтобы получить объем для сервера, его умножают еще и на число одновременных запросов.
Пример: Llama 3.1 70B. У модели 80 слоев, 8 KV-голов и размерность головы 128. В 16-битном формате каждое значение занимает 2 байта.
| Длина контекста | KV-кеш на один запрос (FP16) | KV-кеш на один запрос (FP8) |
|---|---|---|
| 8 тыс. токенов | 2,7 ГБ | 1,3 ГБ |
| 32 тыс. токенов | 10,7 ГБ | 5,4 ГБ |
| 128 тыс. токенов | 43 ГБ | 21,5 ГБ |
Веса этой модели занимают около 140 ГБ в 16-битном формате и около 70 ГБ в 8-битном. Пусть модель с 8-битными весами работает на одном GPU со 141 ГБ памяти, а кеш остается 16-битным. После загрузки весов свободно около 70 ГБ: это примерно два десятка диалогов по 8 тыс. токенов с запасом на служебные расходы. Запрос на 128 тыс. токенов занимает 43 ГБ, и таких запросов сервер обслужит только один.
Число KV-голов напрямую влияет на объем KV-кеша. В Llama 3.1 70B используется grouped-query attention (GQA): 64 головы внимания делят между собой 8 наборов ключей и значений. Без GQA каждая голова хранила бы свои векторы, и кеш был бы в 8 раз больше. Один запрос на 128 тыс. токенов занял бы около 340 ГБ, больше памяти любого отдельного GPU.
Почему память заканчивается раньше расчета
Формула дает нижнюю границу. В реальной работе памяти требуется больше по двум причинам.
Последствия видны пользователю. Сервер либо отказывает в запросе с длинным контекстом, либо движок сокращает число одновременно обрабатываемых запросов. Во втором случае растет очередь, а стоимость одного запроса увеличивается: тот же GPU обслуживает меньше пользователей.
Почему длинный контекст замедляет генерацию
На каждом шаге генерации модель читает весь KV-кеш запроса. Чем длиннее контекст, тем больше данных проходит через память на каждый токен ответа. Даже если кеш целиком поместился в видеопамять, на длинном контексте токены выдаются реже: скорость ограничена пропускной способностью памяти, а не вычислениями.
Как сократить KV-кеш
Кеш сокращают на разных уровнях, от выбора модели до настроек движка инференса. Способы складываются.
Кейс Character.AI: кеш уменьшили в 20 раз
Компания Character.AI, сервис диалогов с ИИ-персонажами, описала свою оптимизацию инференса. Ее модели обрабатывают длинные многоходовые диалоги, и KV-кеш стал главным ограничением.
Команда объединила несколько методов. Multi-query attention сократила объем KV-кеша в 8 раз. Дополнительно использовались ограниченные горизонты внимания и совместное использование KV-кеша между слоями, которое дало еще 2–3 раза. По оценке Character.AI, сочетание этих архитектурных методов уменьшило KV-кеш более чем в 20 раз без снижения качества. Отдельно компания использует int8 для весов, активаций и KV-кеша.
Второй шаг касался повторного использования. Кеш диалога сохраняется между репликами пользователя, и при следующей реплике его не нужно вычислять заново. Доля попаданий в кеш достигла 95%. По данным компании, стоимость обслуживания запросов снизилась в 33 раза по сравнению с концом 2022 года.
Архитектурные способы сокращения KV-кеша задаются при разработке и обучении модели. При работе с готовой моделью можно использовать квантование KV-кеша, страничное управление памятью и кеширование префикса. Итоговый объем кеша зависит от архитектуры модели, формата хранения ключей и значений и настроек движка инференса.
Как выбрать GPU под длинный контекст
Для задач с длинным контекстом важны два параметра GPU. Объем видеопамяти определяет, сколько контекста и сколько одновременных запросов поместится. Пропускная способность памяти влияет на скорость генерации на длинном контексте.
| GPU | Видеопамять | Пропускная способность | Для каких задач |
|---|---|---|---|
| NVIDIA RTX PRO 6000 Blackwell Server Edition | 96 ГБ GDDR7 | 1,6 ТБ/с | Модели от 40 млрд параметров с длинным контекстом |
| NVIDIA H100 (SXM) | 80 ГБ HBM3 | 3,35 ТБ/с | Инференс средних и крупных моделей, высокая нагрузка |
| NVIDIA H200 | 141 ГБ HBM3e | 4,8 ТБ/с | Крупные модели с длинным контекстом и много одновременных пользователей |
Если модель и кеш не помещаются в один GPU, их распределяют между несколькими ускорителями на одном сервере. При тензорном параллелизме каждый GPU хранит свою часть весов и кеша, а на каждом шаге генерации карты обмениваются промежуточными результатами. Скорость обмена задает канал между картами: NVLink там, где он есть, иначе PCIe. У RTX PRO 6000 NVLink нет, и это стоит учитывать при сборке из нескольких карт под одну модель.
Расчет под конкретную задачу идет по шагам:
Такой расчет показывает, помещается ли нагрузка на один GPU или модель и KV-кеш придется распределять между несколькими ускорителями.
GPU-инфраструктура ITGLOBAL.COM
Основа инфраструктуры ITGLOBAL.COM — ускорители NVIDIA: H200 и RTX PRO 6000 Blackwell Server Edition. H200 со 141 ГБ памяти подходит для крупных моделей с длинным контекстом, RTX PRO 6000 с 96 ГБ — для моделей среднего размера. Для проектов, где нужна альтернатива NVIDIA, доступен ИИ-ускоритель SOPHGO SC7 HP75-2. Мощности предоставляются в нескольких форматах.
Для обучения крупных моделей доступна аренда суперкомпьютера на базе NVIDIA SuperPOD.
Серверы размещаются в дата-центрах 7 стран, в том числе в Москве, Минске, Алматы, Ташкенте и Дубае.
Специалисты ITGLOBAL.COM помогут рассчитать объем памяти под вашу модель, длину контекста и число пользователей и подобрать конфигурацию GPU, на которой длинному контексту хватит видеопамяти.
Что учитывать при расчете памяти
При расчете GPU под длинный контекст нужно учитывать память под веса модели, KV-кеш и служебные данные движка. Объем кеша считают для рабочей длины контекста и ожидаемого числа одновременных запросов. Если доступной VRAM не хватает, проверяют квантование и управление кешем, сокращают контекст или распределяют нагрузку между несколькими GPU.
 Предыдущая статья